当 GPT-6 打出「抢着干活」的口号、Claude 把编程与终端操作牢牢按在自家腹地,开源阵营这半年也在同一条战线上加速集结——从 Qwen 3.8、Kimi K3 到腾讯混元 Hy4,几乎每一次亮相都在把「代码 + 智能体」这条主线往前推一格。
一个共同的信号是:模型的价值锚点,正在从「答得漂亮」转向「干得成事」。在这片大语言模型的红海中,一个新玩家正悄然走入视野——至知创新研究院近日开源了模型 IQuest-Q1,主打代码生成、软件工程与复杂任务执行能力。对软件开发领域而言,这类「能干活的模型」正在改变工程交付的方式。
IQuest-Q1 采用稀疏 MoE 架构,总参数约 320B、激活参数仅约 15B,把训练重点放在代码、软件工程与复杂任务执行上,同时向推理、工具使用、长上下文理解与多步任务处理延伸。在同代开源模型里,这属于偏「轻量」的尺寸,但从官方公布的评测和演示看,它给出的结果并不「轻」。目前模型权重与项目 Blog 已同步发布,GitHub 仓库、Hugging Face 模型页与项目主页均已开放下载。
小激活参数,均衡打法
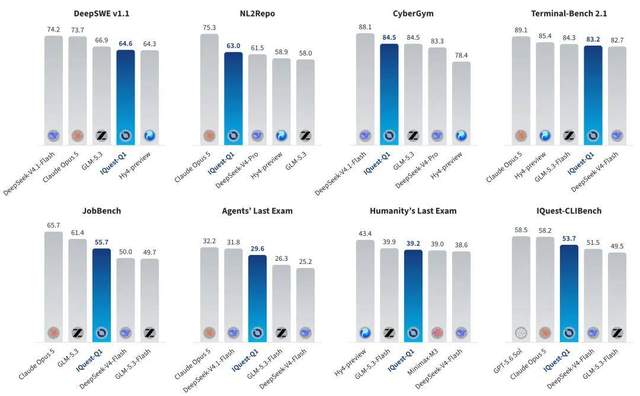
在涵盖代码、软件工程、终端操作、工具使用和复杂智能体任务的多项标准评测中,IQuest-Q1 整体呈现出较为均衡的表现——没有靠单项极高分撑起成绩,各类任务上的能力分布相对完整。
具体来看,IQuest-Q1 在仓库级代码生成 NL2Repo 以及网络安全基准 CyberGym 上取得了稳健的成绩,并在终端 Terminal-Bench 2.1、代码长程任务 DeepSWE v1.1、办公场景 JobBench 等复杂任务评测中展现出均衡的能力。考虑到仅约 15B 的激活规模,这份成绩单在推理成本上也留出了不小的空间。
从写游戏到修 Bug,模型开始「接活」
IQuest-Q1 主打的是「可交付」——模型在任务过程中持续理解上下文、调用工具、处理反馈,最终交出一个可验证的结果,而不是一段停在编辑器里的代码。官方放出的演示覆盖前端交互、3D 场景、训练调试与真实工作环境,基本能勾勒出这款模型的能力边界。
在前端场景,用户一句自然语言指令下去,模型直接输出一个可运行的交互应用。以 FPS 游戏为例,IQuest-Q1 一次性搞定了三维场景、角色移动、射击与换弹、生命值、计分、Boss 战,甚至连资源和装备购买都做了出来——代码生成、多文件组织、交互逻辑、视觉呈现,几件事同时在跑。
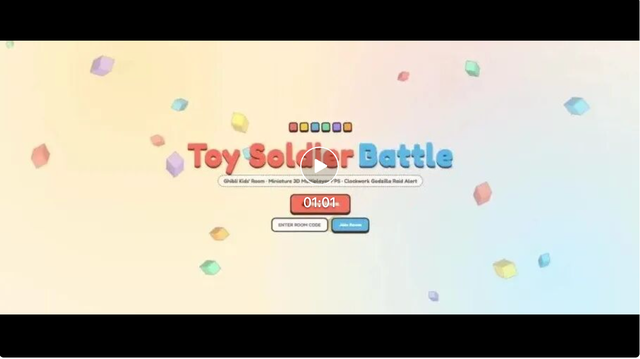
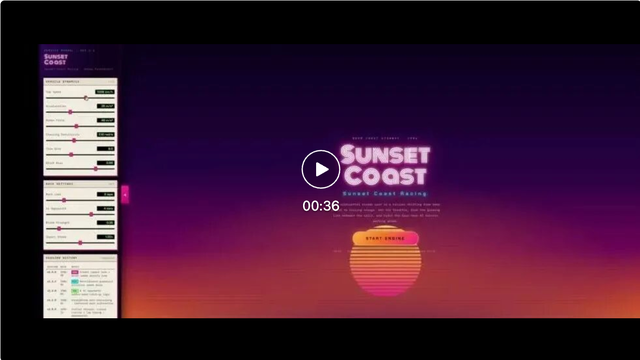
再看赛车游戏这一例。赛道延展、前景与背景的切换,这类场景通常对空间连续性要求很高。IQuest-Q1 处理起来比较从容,说明它在具备空间关系和连续交互需求的应用生成上已经比较扎实。
一次强化学习训练出现异常后,模型顺着训练曲线一路查下去——读日志、看执行轨迹、分析可能原因、定位到具体代码,然后动手修改。修复后重启训练,再用新的指标曲线验证结果。演示中模型给出的根因是「训练轨迹中被插入了一个空格」,改掉之后指标重新爬升。
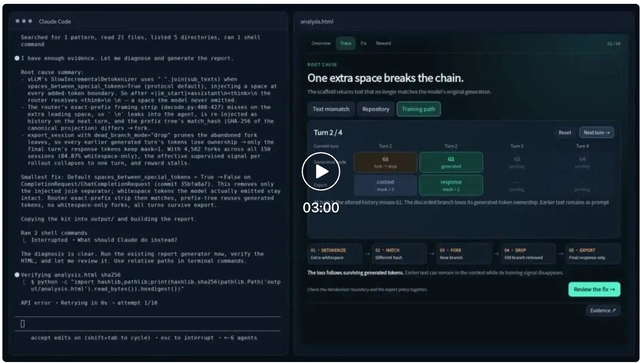
在另一个强化学习训练诊断案例中,系统发现 Reward 异常下降并非来自模型本身,而是由运行环境故障引起。定位问题后,系统修复了环境与评分逻辑,恢复有效奖励信号,避免异常反馈继续影响训练。
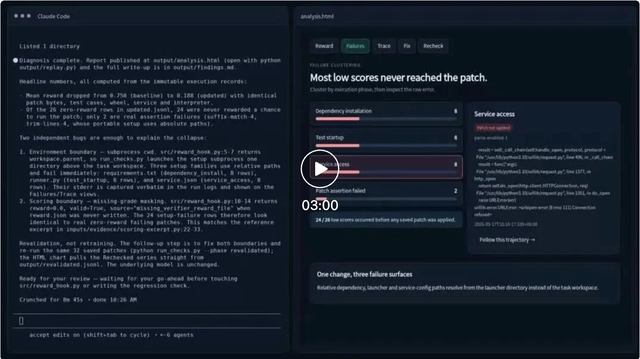
在真实的企业信息化办公场景里,模型接入了聊天、在线文档、表格与评论等一系列上下文,综合信息后完成分析、生成文档、修订结果,最后交付一份可直接「使用」的方案。
技术拆解:320B 总参 / 15B 激活的 MoE 架构
IQuest-Q1 采用 decoder-only Transformer 主干搭配稀疏 MoE,总参数约 320B、激活参数约 15B——在当下动辄「参数越大越强」的开源节奏里,属于把宝押在架构效率和后训练配方上的一路。训练分三段走:预训练奠定基础能力与世界知识,中期训练向复杂任务过渡,后训练则围绕软件工程、长时程任务和通用推理做专项训练,配合监督微调与强化学习进一步收敛能力。
团队还采用了 Multi-Teacher On-Policy Distillation(MOPD),把不同教师模型在各类任务上的强项合并进单一模型,这也是小激活模型追赶大模型的一条常见路径。
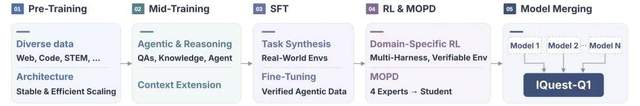
除了模型本身,团队还公开了这一版所使用的研发流程。
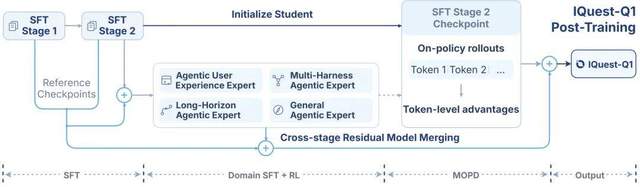
在研发过程中,模型参与能力诊断、训练方案设计和部分实验执行;人类研究人员则负责研究方向调整、高成本实验、版本采用等关键节点的审查与决策。经过验证的模型更新、训练资产和研究流程会进入下一轮迭代直接复用,每轮沉淀下来的数据流程、训练配置、评估方法和工具也会持续积累。
从此次实践来看,这家模型赛道的新玩家在代码智能、复杂任务执行和模型自进化等方向上的探索,已经开始呈现出更清晰的技术脉络,其后续动向值得持续关注。南宁软件开发团队也在关注这类开源代码模型的落地价值。

 外卖跑腿
 —键下单、代买代送代取服务、实时订单跟踪
 人员管理系统
 生活服务系统
 门店经营管理系统
 汽车后市场涵盖汽车保养,汽车养护,汽车维修,汽车救援等服务类型的应用开发
 社区团购
 门店会员管理系统
 相亲交友系统
 短剧视频平台短剧平台快速搭建,源码交付+二次开发
 新零售O2O
 跨境电商
 智慧社区/物业系统
 母婴电商
 智能软硬件


 400-901-7860


