/
资讯
/
NVIDIA DGX Spark 64GB正式发布:桌面级AI超算开启本地大模型部署新时代
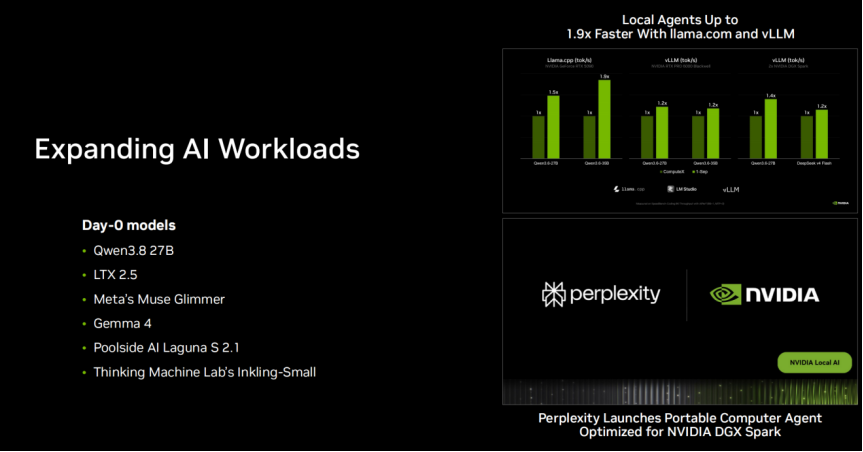
2026年10月2日,NVIDIA在DGX Spark Update会议上正式发布DGX Spark 64GB版,这标志着个人开发者桌面AI计算迎来了全新的选择。此次DGX Spark的更新重申了"将AI超级计算机带到每一位开发者桌面上"的核心愿景,通过一系列底层架构优化与软件栈升级,彻底打破了本地运行前沿大模型的硬件及成本桎梏。在AI智能体呈指数级爆发的当下,云端推理的成本与延迟痛点日益凸显,DGX Spark凭借完整的本地AI平台能力、ConnectX-7集群扩展技术以及深度优化的CUDA软件栈,为开发者提供了一套无缝衔接的本地算力解决方案。
当前,人工智能的发展正经历从"模型训练"向"智能体(Agent)应用"的深刻转型。根据2026年5月初的顶级开源模型数据快照,AI智能体在GitHub上的星标数自2012年以来呈现出惊人的指数级增长,相关项目如Linux、PyTorch、Hermes和OpenClaw等热度持续攀升,从最初的100k飙升至373k。更令人瞩目的是,在OpenRouter平台上,高达80%的Token用量已经由Agent贡献,Top 50应用中的Agent每月Token消耗量更是达到了惊人的27万亿次。这一数据直观地反映出,AI正在从单纯的问答工具演变为具备自主规划、工具调用和持续交互能力的复杂系统。
AI智能体时代的到来对硬件提出了极其苛刻的要求。传统的PC架构在面对高频、长上下文的交互时,往往因为显存容量不足或内存带宽瓶颈而捉襟见肘。DGX Spark将完整的CUDA加速AI软件栈下放至桌面,意味着开发者不再需要为了运行一个智能体而去排队等待云端GPU实例。这种"算力主权"的回归,将极大激发本地AI应用的创新活力,让桌面PC重新成为极客与开发者最核心的生产力工具。
要在桌面级设备上流畅运行27B参数级别的大模型,是一项颇具挑战的系统工程。DGX Spark 64GB通过NVFP4量化格式、模型架构优化等针对桌面端硬件特性进行了算子级别的深度定制。NVIDIA为DGX Spark配置的KV Cache效率提升与投机解码技术的引入,通过优化注意力机制的内存访问模式,显著降低了KV Cache的冗余占用,并在不损失精度的前提下大幅提升了生成速度。在AI搜索引擎公司Perplexity针对llama.cpp、vLLM等的深度优化下,如今本地智能体在DGX Spark上的运行速度相比首发时最高可以提升1.9倍。
从Artificial Analysis Intelligence Index v4.3的评分来看,这种技术路线的成效十分显著。虽然Claude Fable 5.1 (Max With Fallback)以53分领跑,Claude Opus 5 (Max)为51分,但本地部署的Qwen3.8 27B (x High)取得了34分的成绩,与GLM-5.3-Flash(42分)、Qwen3.8-Flash-Next(40分)等云端轻量级模型差距在10分以内,基本处于同一竞争梯队。这意味着,开发者在桌面上即可获得媲美云端主流Flash模型的智能体验,且完全掌握数据主权。
64GB统一内存版本是面向广大开发者和进阶用户的最核心亮点。相较于此前发布的128GB版本,64GB版本凭借极高的性价比和出色的内存调度效率,成为桌面AI算力的"黄金配置"。其核心优势在于革命性的统一内存架构,在这种架构下,CPU与GPU共享同一块64GB的高带宽内存池,彻底消除了传统PC中数据在显存与内存间拷贝的PCIe带宽瓶颈。系统预留约8GB用于操作系统与基础服务,用户可用空间约为56GB,这为本地大模型部署提供了极为宽裕的KV Cache余量,直接决定了长上下文推理的能力上限。
在具体模型兼容性方面,DGX Spark 64GB展现了极强的包容性与工程实用性。以Gemma 4 26B-A4B为例,这是一款采用MoE(混合专家)架构的模型,总参数26B但活跃参数仅为4B,其权重仅占用15GB内存,剩余的41GB全部可用于KV Cache,这意味着它可以轻松处理超长上下文任务。相比之下,Qwen3.8 27B(Dense架构)权重占用16.5GB,剩余40GB给KV Cache;Gemma 4 31B(Dense)占用18GB,剩余38GB。对于更大规模的模型,如Qwen3.6 35B-A3B(MoE,3B活跃),权重占用21GB,仍有35GB的KV空间。
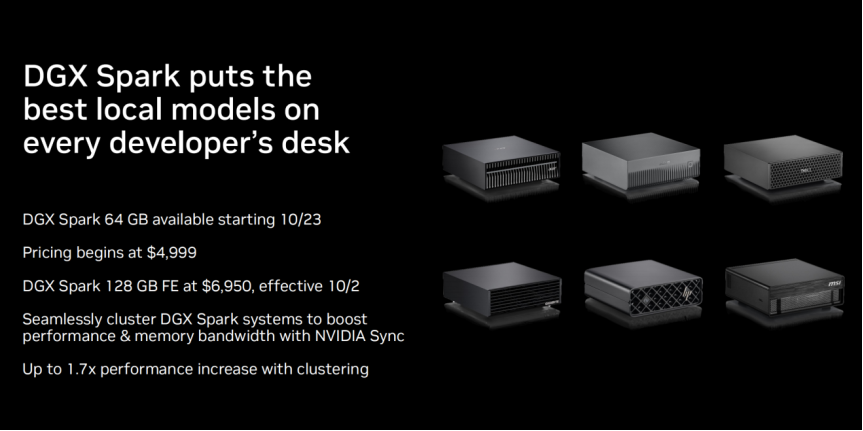
价格方面,DGX Spark 64GB起售价定为4999美元,将于2026年10月23日正式发售。这一极具竞争力的定价,配合宏碁、华硕、戴尔、技嘉、惠普及微星等OEM厂商同步推出的便携版本,标志着桌面AI超算正在走向普及化。
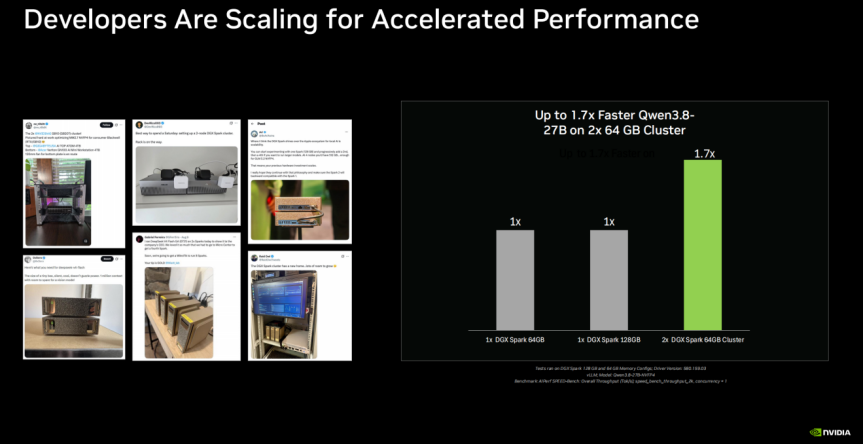
如果觉得单机算力无法满足需求,DGX Spark 64GB提供了无缝的集群扩展能力。NVIDIA展示的基准测试显示,在AIPerf SPEED-Bench测试中,2台64GB DGX Spark组成的集群在Overall Throughput (Tok/s)上实现了最高1.7倍的性能提升。这意味着开发者可以通过简单的物理连接,将桌面设备线性扩展为小型AI超算,以应对更大规模的微调或更高并发的推理任务。
为了降低集群管理的复杂度,NVIDIA还推出了NVIDIA Sync工具。它不仅支持远程连接DGX Spark以检查系统状态,还能无缝对接Cursor、VS Code和AI Workbench等主流开发环境。这种从单机到多集群的平滑拓展路径,完美契合了开发者从原型验证到规模化部署的全生命周期需求。
对于从事软件开发的团队而言,DGX Spark 64GB的发布意味着本地部署和调试AI模型的门槛进一步降低。特别是对于需要集成大模型能力的App开发项目,开发者可以在桌面上完成从原型验证到性能测试的全流程,无需依赖云端资源。南宁本地的企业信息化解决方案提供商也在关注此类桌面级AI算力设备,以便为客户提供更高效的智能化升级服务。

 外卖跑腿
 —键下单、代买代送代取服务、实时订单跟踪
 人员管理系统
 生活服务系统
 门店经营管理系统
 汽车后市场涵盖汽车保养,汽车养护,汽车维修,汽车救援等服务类型的应用开发
 社区团购
 门店会员管理系统
 相亲交友系统
 短剧视频平台短剧平台快速搭建,源码交付+二次开发
 新零售O2O
 跨境电商
 智慧社区/物业系统
 母婴电商
 智能软硬件


 400-901-7860


