/
资讯
/
蚂蚁百灵开源 Ling-3.1-flash 大模型:总参数约 560B、激活约 25B,最高支持 1M 上下文
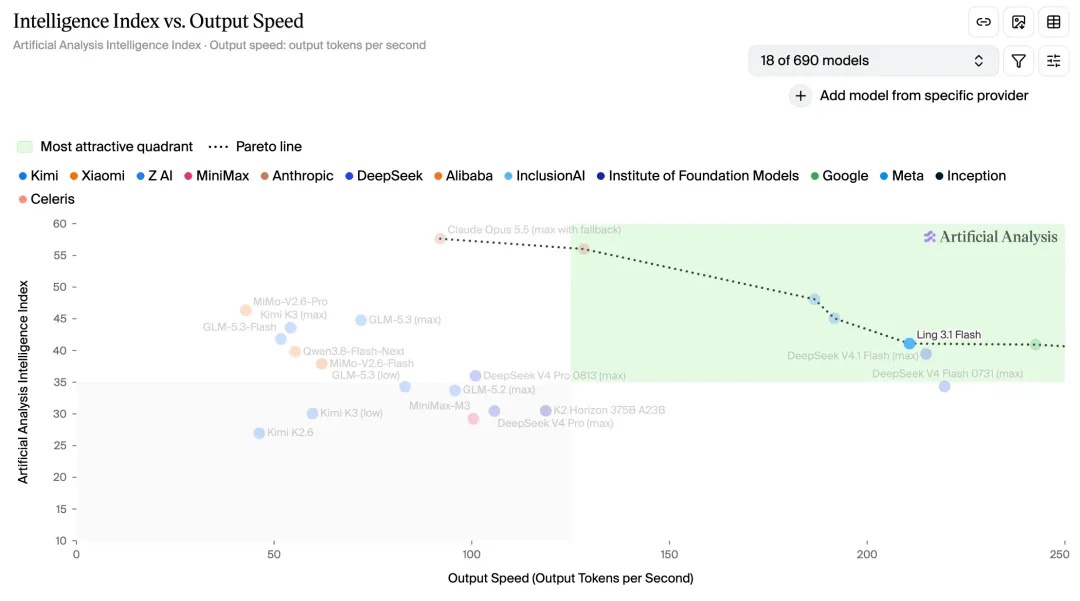
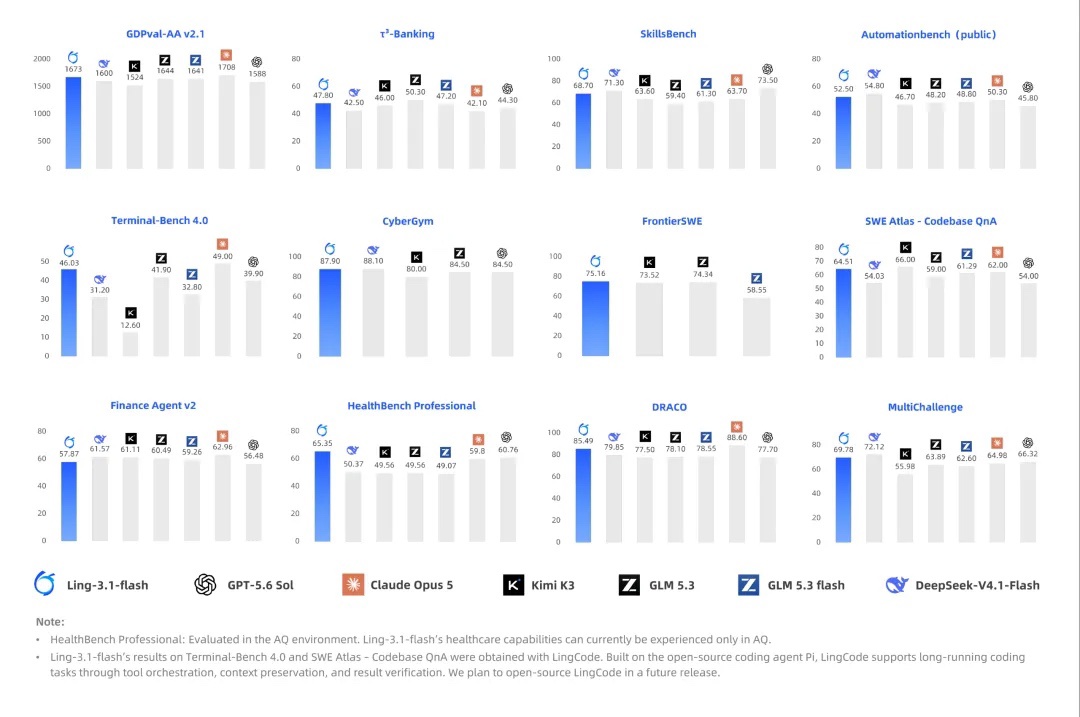
蚂蚁百灵宣布开源 Ling-3.1-flash 模型。该模型总参数约 560B,每个 Token 激活约 25B,最高支持 1M 上下文。在 Artificial Analysis 的公开评测中,Ling-3.1-flash 的智能指数为 41、输出速度约为每秒 210 Token。对希望通过自研或集成大模型增强自身软件开发能力的团队而言,这类开源权重模型提供了可自主部署的选项。
针对本地部署,团队对 routed experts 采用 MXFP4 量化、dense 层保持 block-FP8,权重占用从约 534GB 降至 292GB。在对应的 Hopper GPU 测试配置中,服务部署由 8 卡降至 4 卡,让具备服务器级 GPU 的团队以更少卡数运行模型;实际需求仍随上下文、并发量和服务配置而变。针对长资料处理,团队提供长上下文并行推理方案(PCP / DCP);工具调用也加强了对 JSON Schema 的支持,方便与现有业务接口对接。
企业知识问答、办公助手等场景常需要先读取较长资料,而用户仍希望尽快看到回复。团队通过算子融合与投机解码减少推理开销:在平均输入约 25.47K Token、输出约 224 Token、缓存命中率 76% 的模拟生产请求中,8 卡 Hopper 配置下平均首 Token 时间为 604 毫秒,相邻输出 Token 平均间隔为 3.28 毫秒。在 4 卡 Hopper 吞吐测试中,模型达到约 1.36 QPS,同时满足首 Token 时间 P50 小于 3 秒、相邻输出间隔 P90 小于 70 毫秒的约束,为自有部署的容量规划提供了参考。
在线体验方面,Ling-3.1-flash 目前提供限时 2.5 折优惠,OpenRouter(美元计价)输入 0.075 美元、输出 0.225 美元、缓存读取 0.015 美元;Ling Studio(人民币计价)输入 0.5 元、输出 1.5 元、缓存读取 0.1 元。这类支持长上下文、强化 JSON Schema 工具调用的开源模型,很适合落地到智能管理系统、知识库问答等应用。
对南宁本地软件开发团队来说,选择可自主部署的开源大模型,既能在数据可控的前提下引入 AI 能力,也能通过量化与并行推理方案,把服务器成本压到可接受的范围内。

 外卖跑腿
 —键下单、代买代送代取服务、实时订单跟踪
 人员管理系统
 生活服务系统
 门店经营管理系统
 汽车后市场涵盖汽车保养,汽车养护,汽车维修,汽车救援等服务类型的应用开发
 社区团购
 门店会员管理系统
 相亲交友系统
 短剧视频平台短剧平台快速搭建,源码交付+二次开发
 新零售O2O
 跨境电商
 智慧社区/物业系统
 母婴电商
 智能软硬件


 400-901-7860


